NATURAL LANGUAGE PROCESSING · 02
理解 One-Hot、Word Embedding、Word2Vec、CBOW、Skip-gram 与 FastText。
- 词向量
- Word2Vec
词向量表示
1.独热编码
将词转化为稀疏向量
在One-hot编码中,对于一个具有n个不同类别的分类变量,将其表示为一个n维的向量 其中只有一个维度的值为1(代表该样本属于这个类别),其他维度的值均为0
优点:便于理解,操作简单
缺点:词与词之间没有联系,大语料集下占据大量内存
cabs = ["关羽",'张飞','赵云','黄忠','典韦','许褚','小乔','大乔']

# 转为词典
cabs_dict = {cab:i for i,cab in enumerate(cabs)}
print(cabs_dict)

# 转为one-hot
cab_one_hot = [0]*(len(cabs_dict))

for cab in cabs:
    cab_one_hot = [0] * (len(cabs_dict))
    cab_one_hot[cabs_dict[cab]] = 1
    print(cab,cab_one_hot)
2.3 WordEmbedding 稠密词向量表示
通过一定的方式将词汇映射到指定维度(一般是更高维度)的空间
广义的word embedding:所有密集词汇向量的表示方法。word2vec可认为是word embedding的一种。
广义的word embedding可使用浅层神经网络,也可使用深层神经网络表示词向量
nn.embedding与word2vec的区别
word2vec产生词向量后,某一个词向量比如单词“the”词向量就固定下来了,是静态的。 nn.Embedding层产生词向量后,词嵌入层作为整体神经网络的一部分,权重参数会参与更新,是动态的
word2vec使用起来一般需要两步:1)输入单词the拿到词向量,2)再送给神经网络进行使用 nn.Embedding层使用起来更方便就1步。直接嵌入到神经网络中,更易使用
#nn.embedding使用
embed = nn.Embedding(len(tokenizer.word_index),8)
# 参1:样本大小  参2:维度
2.3.1word2Vec
稠密向量
用深度学习网络来探索单词与单词之间的语义关系
搭建神经网络,用神经网络的w权重表示词向量
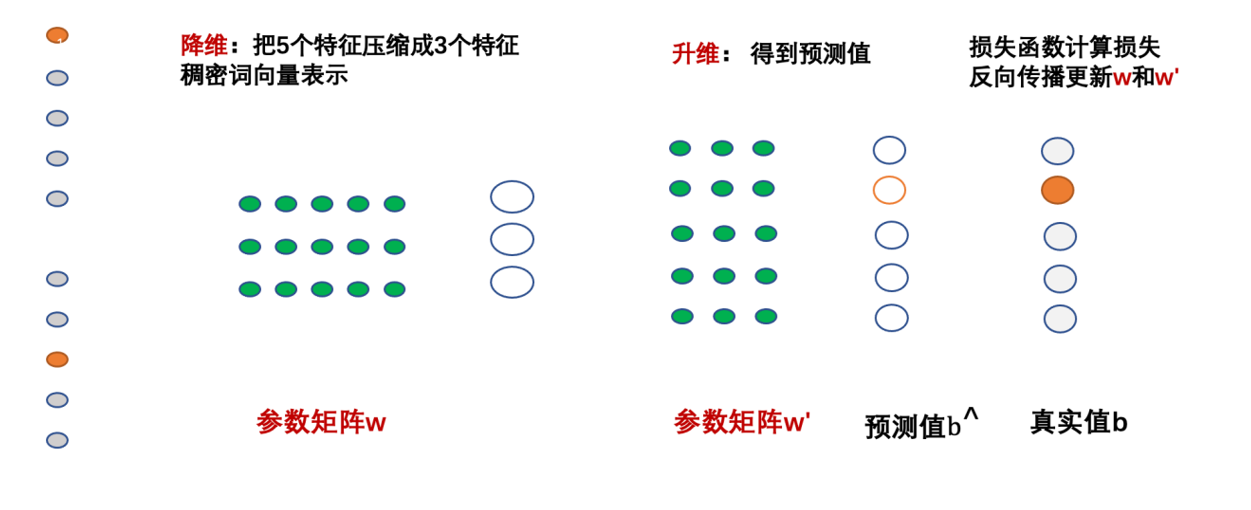
2.3.2 CBOW
基于两次预测中间 –对两个输入经过激活函数后进行平均/求和输出一个结果
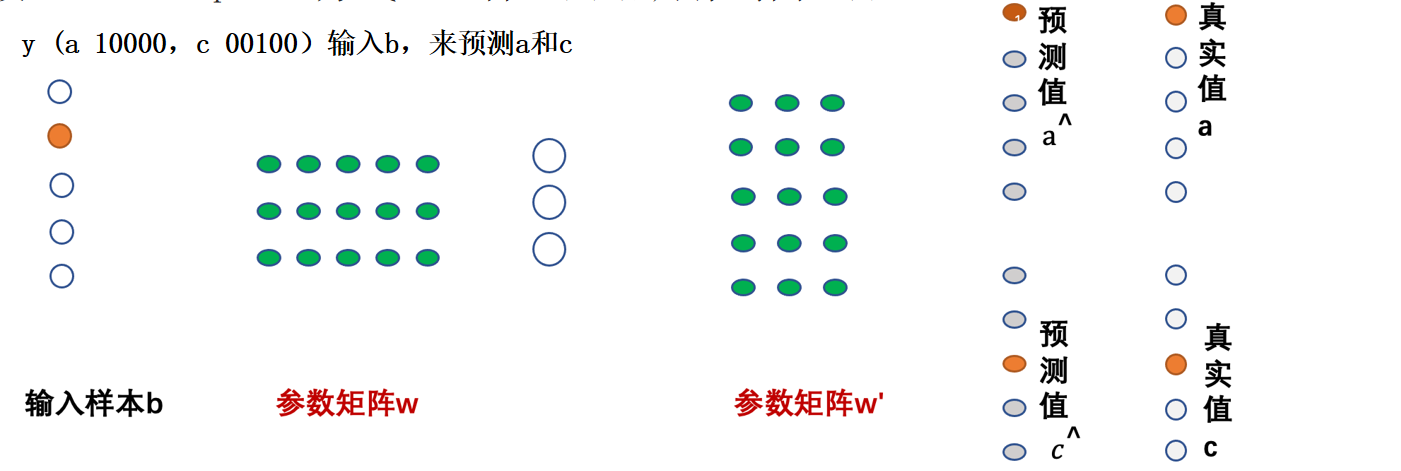
2.3.3 Skip—gram
基于中间预测两端–对一个输入进行两次预测得到两个输出
2.3.4 Fasttext
# 作用:训练文本分类模型。

# 训练分类模型
fasttext.train_supervised()/train_unsupervised()

# 保存模型
model.save_model()
# 加载模型
fasttext.load_model()
# 获取词向量
model.get_word_vector(word)
# 查找相似词
model.get_nearest_neighbors(word)
2.4各模型之间的关系
词表示方法
├── One-Hot 编码(离散、稀疏)
└── Word Embedding 词嵌入(连续、稠密)
    ├── Word2Vec(Google, 2013)
    │   ├── CBOW(连续词袋模型)
    │   └── Skip-gram(跳字模型)
    └── FastText(Facebook, 2016)
└── 基于 Skip-gram + 子词 n-gram 信息One-Hot 编码
每个词用一个超长向量表示,只有对应位置为1,其余全为0
致命缺陷:词与词之间正交,无法体现语义相似性("猫"和"狗"的距离 = "猫"和"飞机"的距离)
Word2Vec — CBOW(Continuous Bag of Words)
思路:已知上下文词,预测中间的目标词
类比:做完形填空——"今天天气真___",根据"今天""天气""真"猜出"好"
优点:训练速度快,适合小数据集
Word2Vec — Skip-gram
思路:已知中心词,预测它周围的上下文词
类比:已知"好",预测它周围可能出现"天气""真""今天"
优点:对低频词效果更好,语义质量通常略优于 CBOW
FastText
核心创新:不再以"词"为最小单位,而是将词拆解为字符级 n-gram 子词
例如:"where" → <wh, whe, her, ere, re> + <where>
优点:
能处理未登录词(OOV)——即使没见过"running",也能通过子词"run""nin""ing"组合出向量
形态相似的词(如 "eat""eating""eats")天然共享子词,向量更相近