NATURAL LANGUAGE PROCESSING · 01
认识自然语言处理,并学习分词、命名实体识别和词性标注。
- NLP
- 文本预处理
NLP 与文本预处理
1.NLP概念
让计算机理解人类语言和生成人类语言
自然语言理解
自然语言生成
2.文本预处理
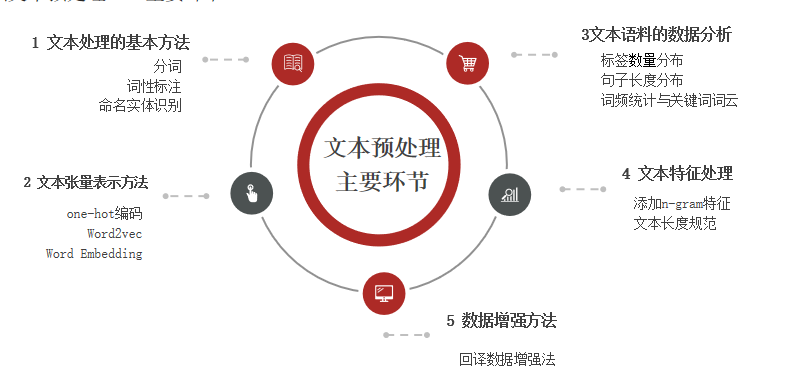
2.1 分词
2.1.1分词的三种模式
1.精准模式–适合所有文本分析
jieba支持繁体中文分词
jieba.cut(text) - 生成器
jiaba.lcut(text) - 列表
2.全模式–扫描句子中所有词语
速度很快,但是不能消除歧义
jieba.cut(text,cut_all=Ture) - 生成器
jiaba.lcut(text,cut_all=Ture) - 列表
3.搜索模式
在精确模式的基础上,对长词再次切分,提高召回率
jieba.cut_for_search()
jieba.lcut_for_search()
4.自定义用户词典
1. 准备 一个词典(词 词频 词性)
2. 加载 jieba.load_userdict("")
3. 分词 jieba.lcut()
2.1.2 命名实体 NER
ENR:可以识别出一段文字中可能存在的命名实体
命名实体:将人名、地名、机构等专有名词统称命名实体
2.1.3 词性标注 POS
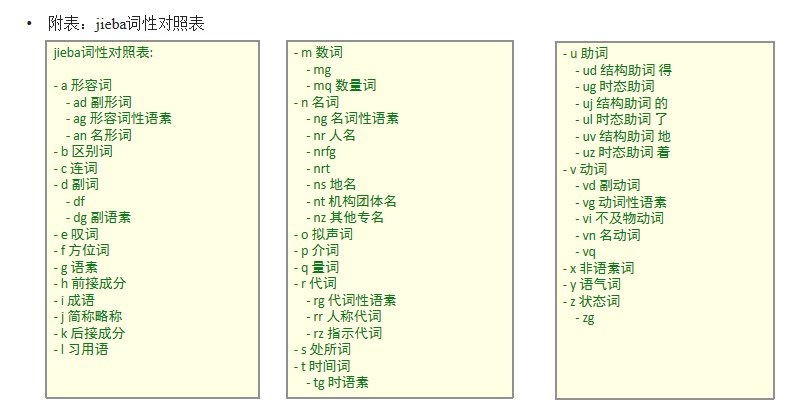
import jieba.posseg as pseg
# (Part-Of-Speech tagging, 简称POS)

def dm04_jieba_pos():
    sentence = '我爱北京天安门'
    mydata = pseg.lcut(sentence)
    print('mydata-->', mydata)
# 返回结果 1:pair元组的列表 2:每个pair元组由词汇和词性组成
# mydata --> [pair('我', 'r'), pair('爱', 'v'), pair('北京', 'ns'), pair('天安门', 'ns')]