NATURAL LANGUAGE PROCESSING · 03
分析文本标签数量、句子长度、词频统计与关键词词云。
- 文本分析
- 词频统计
文本数据分析
作用:
帮助我们理解数据语料,快速检查出语料中可能存在的问题
分类:
标签数量分布
句子长度分布
词频统计与关键词云
3.1 标签数量分布
def lable_train():
    # 1.读取数据
    train_data = pd.read_csv("./train.tsv",sep="\t")
    test_data = pd.read_csv("./dev.tsv",sep="\t")
    # 2.查看数据
    # print(train_data)
    # 3. 绘制图像
    seaborn.countplot(x="label",data = train_data,hue="label")
    # 4.画图展示
    plt.title('train_data')
    plt.show()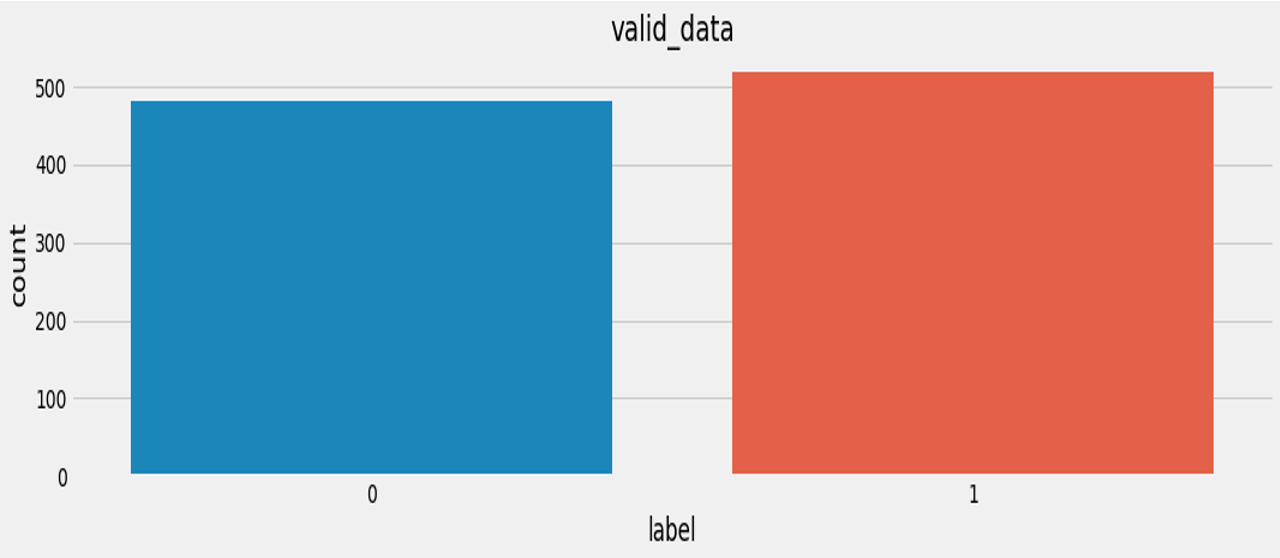
3.2 句子长度分布
柱状图与曲线图
def length_distribution():
    # 1.读取数据
    train_data = pd.read_csv('./train.tsv',sep='\t')
    test_data = pd.read_csv('./dev.tsv',sep='\t')
    # print(train_data)
    # 2. 获取句子长度-map
    # map 遍历列表,让每个值执行前面的函数
    train_data['length'] = list(map(lambda x:len(x),train_data['sentence']))
    test_data['length'] = list(map(lambda x:len(x),test_data['sentence']))
    # 3. 绘制柱状图
    sns.countplot(x="length",data = train_data)
    # 3.1 画图展示
    plt.title('train_data')
    plt.show()
    # 4.绘制曲线图
    sns.histplot(x="length",data = train_data)
    # 4.1 画图展示
    plt.title('train_data')
    plt.show()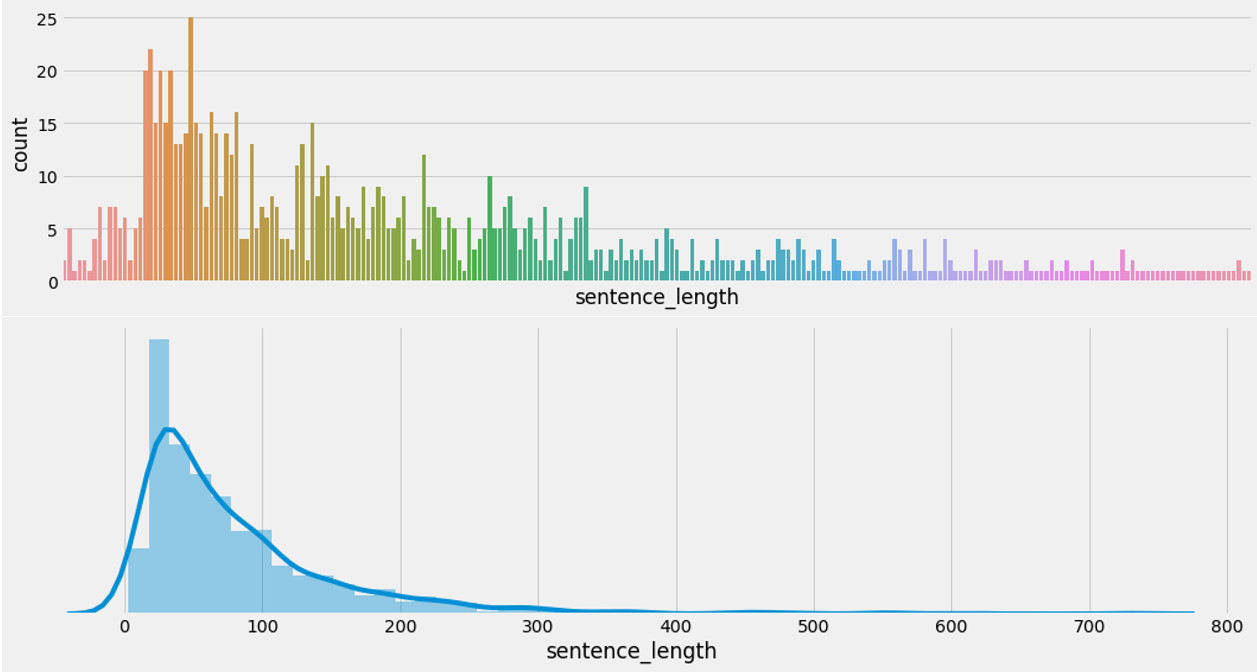
散点图
def length_distribution():
    # 1.读取数据
    train_data = pd.read_csv('./train.tsv',sep='\t')
    test_data = pd.read_csv('./dev.tsv',sep='\t')
    # print(train_data)
    # 2. 获取句子长度-map
    train_data['length'] = list(map(lambda x:len(x),train_data['sentence']))
    test_data['length'] = list(map(lambda x:len(x),test_data['sentence']))
    # 3. 绘制散点图
    sns.stripplot(x="label", y="length", data=train_data,hue="label")
    # 3.1 画图展示
    plt.title('train_data')
    plt.show()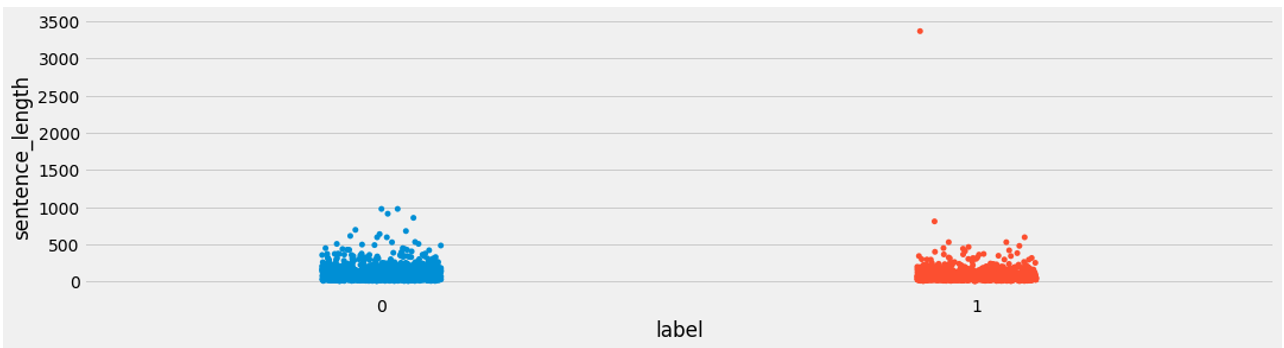
3.3词频统计与关键词词云
1.句子词汇提取
def extract_words():
    # 1.读取数据
    train_data = pd.read_csv('./train.tsv',sep='\t')
    # 2.切词
    # chain(将内容拼接在一起,是一个迭代器)
    # map(函数,迭代器)将函数作用于迭代器的每一个元素
    # set(集合,拿到迭代器的所有内容并去重)
    train_words = set(chain(*map(lambda x:jieba.lcut(x),train_data['sentence'])))
    print(len(train_words))
2.绘制词云
# 1.获取形容词词表
def get_adj_words(text):
    list = []
    for i in jieba.posseg.lcut(text) :
        if i.flag == 'a' :
            list.append(i.word)
    return list

# 2.绘制词云图
def draw_cloud(text) :
    # 1.设置画板
    wordcloud = WordCloud(
        font_path='SimHei.ttf',
        max_words=100,
        background_color='white',
    )
    # 2.数据格式转换
    text = ' '.join(text)
    # 3.绘制词云图
    wordcloud.generate(text)
    # 4.画图
    # 画图
    plt.figure()
    plt.imshow(wordcloud, interpolation="bilinear")
    plt.axis('off')
    plt.show()


def get_adj_words_cloud():
    # 1.获取数据
    train_words = pd.read_csv('./train.tsv',sep='\t')
    # print(train_words.head())
    # 2.获取正向形容词词表
    p_a_list = train_words[train_words["label"]==1]["sentence"]
    # 3.将词表转为列表
    p_a_list = chain(*map(lambda x:get_adj_words(x),p_a_list))
    # 3.绘制词云图
    draw_cloud(p_a_list)