DEEP LEARNING · 05
整理损失函数、梯度下降、优化算法、正则化和归一化方法。
- 模型训练
- 优化器
本文目录
神经网络训练与优化
4.1 分类问题损失函数
1.二分类–BCELOSS
# 二分类交叉熵损失--用于衡量二分类误差衡量
# BCELoss
import torch
y_pre = torch.tensor([0.9, 0.1],requires_grad=True,dtype=torch.float32)
y = torch.tensor([1, 0],dtype=torch.float32)
loss_fn= torch.nn.BCELoss()
loss = loss_fn(y_pre, y)
print(loss)
2.多分类–CrossEntropyLoss
# 多分类交叉熵损失 -- 衡量多分类问题的损失
# CrossEntropyLoss
import torch

y_pre = torch.tensor([[0.1, 0.2, 0.7],[0.3,0.4,0.3]],requires_grad=True,dtype=torch.float32)
# y = torch.tensor([2,1],dtype=torch.int64)
y = torch.tensor([[0, 1, 0],[1, 0, 0]],dtype=torch.float32)

loss_fn= torch.nn.CrossEntropyLoss()
loss = loss_fn(y_pre, y)
print(loss)
4.2 回归问题损失函数
回归问题损失函数:
L1Loss – 梯度可能会丢失 绝对误差
MSELoss – 梯度可能爆炸 均方误差
smooth L1 Loss –结合了前两者的优点
# 1.L1Loss  == MAELoss 在0点可能会梯度消失
# 2.L2Loss == MSRLoss 当预测和真实差异过大可能会梯度爆炸
# 3.Smooth L1 Loss  结合l1和l2的优点

import torch
y_pre = torch.tensor([0.1,0.2,0.3])
y = torch.tensor([0.08,0.17,0.3])

# 1.使用L1loss计算损失函数
loss_fn = torch.nn.L1Loss()
loss = loss_fn(y_pre, y)
print(loss)

# 2.使用L2loss计算损失函数
loss_fn2= torch.nn.MSELoss()
loss = loss_fn2(y_pre, y)
print(loss)

# 3.使用smooth L1 Loss  计算损失函数
loss_fn3 = torch.nn.SmoothL1Loss
loss = loss_fn3(y_pre, y)
print(loss)
5. 梯度下降
Epoch: 自定义的训练轮次
total: 样本总数
batch_size: 自定义的把每次训多少条数据源
批次:total/batch_size (向上取整)
Iter:训练次数
5.1 梯度下降的几种方式
BGD:全梯度下降
SGD:随机梯度下降
Mini-Batch 少样本梯度下降 – 优选
6.反向传播(BP算法)
正向传播: 从输入层将特征经过每一层神经元的加权求和和激活函数计算一直传输到输出层,得到一个预测值
损失函数 = 衡量预测值与真实值之间的误差
反向传播: 从后往前,利用损失函数和梯度下降,对参数进行更新
7.梯度下降的优化方法–指数加权平均
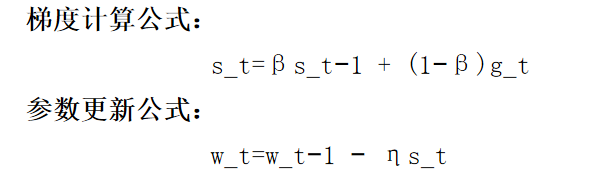
思想:指数加权平均,要参考之前的所有的梯度,离我越近的权重越高
7.1 动量算法–Momentum
# 2 实例化优化方法:SGD 指定参数beta=0.9
optimizer = torch.optim.SGD([w], lr=0.01, momentum=0.9)

# 让梯度在改变时参考之前的梯度
7.2 Adagrad
optimizer = torch.optim.Adagrad ([w], lr=0.01)

#改变学习率
#使权重先下降很快,后下降慢
7.3RMSProp
optimizer = torch.optim.RMSprop([w], lr=0.01,alpha=0.9)

#改变学习率
7.4Adam
#结合了上面几种的优点,既改变梯度也改变学习率

# 2 实例化优化方法:Adam算法,其中betas是指数加权的系数
optimizer = torch.optim.Adam([w], lr=0.01,betas=[0.9,0.99])
8.学习率衰减方法
学习率设置不当可能会出现梯度下降缓慢或者梯度震荡的情况
8.1等间距学习率衰减
衰减率、衰减步长(每次步长一致)
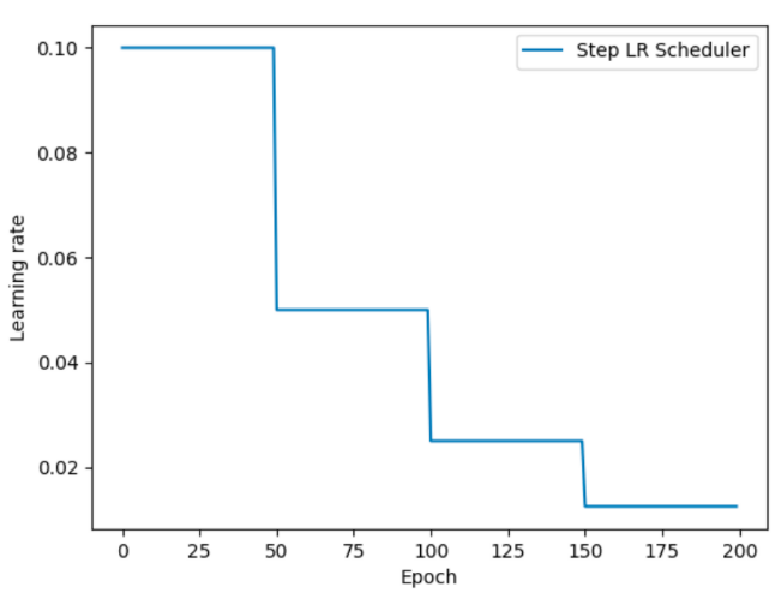
#   step_size:调整间隔数=50
#   gamma:调整系数=0.5
#   调整方式:lr = lr * gamma
lr_scheduler.StepLR(optimizer, step_size, gamma=0.1)
8.2指定间距学习率衰减
衰减率,衰减步长(每次的步长都可以自定义,每次可以不同)
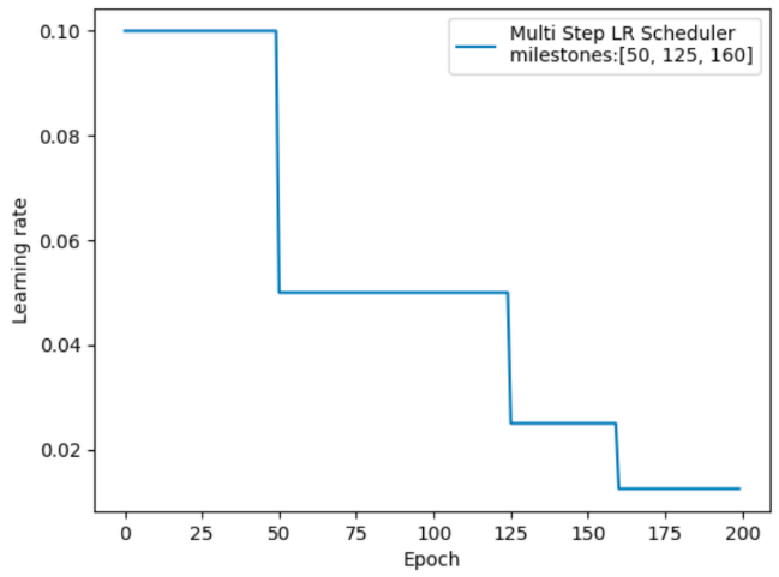
# milestones:设定调整轮次:[50, 125, 160]
# gamma:调整系数
# 调整方式:lr = lr * gamma
optim.lr_scheduler.MultiStepLR(optimizer, milestones, gamma=0.1)
8.3指数学习率衰减
平滑的曲线,没有 步长
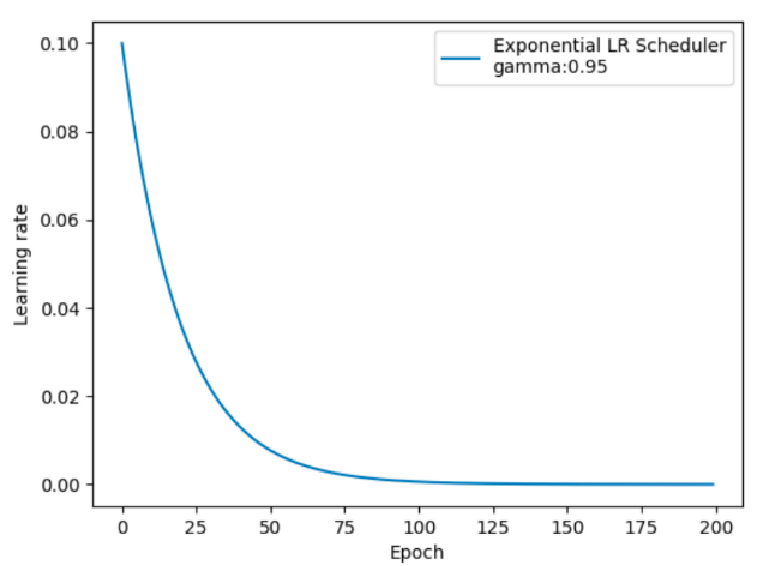
# gamma:指数的底
# 调整方式
# lr= lr∗ gamma^epoch
optim.lr_scheduler.ExponentialLR(optimizer, gamma)
9.正则化
9.1 Dropout正则化
在训练时使用
在激活函数之后使用
解决过拟合问题
思想:每次训练随机失活几个神经元,确保每个神经元都被训练到
# 1.准备数据
import torch
t1 = torch.randint(1,10,(3,4),dtype=torch.float32)
print(t1)
# 2.搭建隐藏层
fc1 = torch.nn.Linear(4,3)
# 3.加权求和
data = fc1(t1)
# 4.激活函数
data = torch.tanh(data)
# 5.正则化
# 5.1 实例化写法
# drop = torch.nn.Dropout(0.5)
# data = drop(data)
# 5.2 函数写法
data = torch.nn.functional.dropout(data,p=0.5)
print(data)
10.标准化、归一化
10.1 Dropout 正则化
作用的时机:
1.缓解过拟合的问题
2.训练模型的时候使用
3.激活函数后使用
逻辑:
训练的过程中,以概率p随机让神经元失活,其他神经元以1/(1-p)的缩放
# 1.准备数据
import torch
t1 = torch.randint(1,10,(3,4),dtype=torch.float32)
print(t1)
# 2.搭建隐藏层
fc1 = torch.nn.Linear(4,3)
# 3.加权求和
data = fc1(t1)
# 4.激活函数
data = torch.tanh(data)
# 5.正则化
# 5.1 实例化写法--自动在训练集使用
# drop = torch.nn.Dropout(0.5)
# data = drop(data)
# 5.2 函数写法--手动设置训练集
data = torch.nn.functional.dropout(data,p=0.5,training=True)
print(data)
10.2 批量归一化
作用的时机:
激活函数前,加权求和后
逻辑:
1.每个神经元数据内容标准化
2.对标准化的内容学习一个λ和β
(防止特征被Relu杀死,以及数据的有效性)
# 1.准备数据
import torch
t1 = torch.randint(1,10,(3,4),dtype=torch.float32)
print(t1)
# 2.搭建隐藏层
fc1 = torch.nn.Linear(4,3)
# 3.加权求和
data = fc1(t1)
# 3.5 批量归一化
bn = torch.nn.BatchNorm1d(3)     # 1d一般作用于全连接层
# bn = torch.nn.BatchNorm1d(两样本,三特征)
# bn = torch.nn.BatchNorm2d(3)   #2d一般用于3通道的图片
# bn = torch.nn.BatchNorm2d(一张,三通道,高50,宽30的图片)   #2d一般用于3通道的图片
# bn = torch.nn.BatchNorm3d(3)   #3d一般用于深度的图片(高维)
# bn = torch.nn.BatchNorm3d(一张,深度为2,三通道,高50,宽30的的图片)   #3d一般用于深度的图片(高维)
data = bn(data)
# 4.激活函数
data = torch.tanh(data)
# 5.正则化
# 5.1 实例化写法--自动在训练集使用
# drop = torch.nn.Dropout(0.5)
# data = drop(data)
# # 5.2 函数写法--手动设置训练集
# data = torch.nn.functional.dropout(data,p=0.5,training=True)
print(data)
11.神经网络搭建案例
流程:
1.数据准备
2.网络搭建
2.1 init
2.1.1 参数初始化
2.1.2 搭建神经网络
2.2 forward
2.2.1加权求和
- 2.2标准化、归一化
2.2.3 激活函数
3.训练模型
3.1 准备模型
3.2 准备优化器
3.3 模型预测
3.4 损失函数–自动微分
3.5正则化 –缓解过拟合
3.6 更新参数 (梯度下降优化方法,学习率衰减方法)
3.7 梯度清零
3.8保存模型
4.预测
使用测试集预测模型
5.评估
对比预测值和真实值评估模型准确率
模型调优:
1.批量归一化
2.更换优化器 Adma
3.增加循环次数
4.学习率调整
5.学习率衰减
6.增加隐藏层
import numpy as np
import pandas as pd
import torch
from sklearn.model_selection import train_test_split
from torch import optim
from torchsummary import summary


# 1. 准备数据
def creat_data():
    # 1.读取数据
    data = pd.read_csv('手机价格预测.csv')
    # print(data.shape)
    # 2.分割数据
    x = data.iloc[:,:-1]
    print(x.shape)
    y = data.iloc[:,-1]
    # print(y.shape)
    # 3.划分训练集和测试集
    x_train,x_test,y_train,y_test = train_test_split(x,y,test_size=0.2,random_state=22)
    # 4. 封装训练集和测试集
    # 数据 -> 张量 -> 数据集
    train_data = torch.utils.data.TensorDataset(torch.FloatTensor(x_train.values),torch.Tensor(y_train.values))
    test_data = torch.utils.data.TensorDataset(torch.FloatTensor(x_test.values),torch.Tensor(y_test.values))
    # 5.返回数据集及输入输出
    return test_data,train_data,x.shape[1],len(np.unique(y))

# 2. 准备模型
class PhonePriceModel(torch.nn.Module):
    def __init__(self,input_dim,output_dim):
       super().__init__()
       # 输入层 -20
       self.fc1 = torch.nn.Linear(input_dim,128)
       self.fc2 = torch.nn.Linear(128,256)
       self.fc3 = torch.nn.Linear(256,128)
       self.out = torch.nn.Linear(128,output_dim)
       # 批量归一化
       self.bn1 = torch.nn.BatchNorm1d(128)
       self.bn2 = torch.nn.BatchNorm1d(256)
       self.bn3 = torch.nn.BatchNorm1d(128)

    def forward(self,x):
        x1 = torch.relu(self.bn1(self.fc1(x)))
        x2 = torch.relu(self.bn2(self.fc2(x1)))
        x3 = torch.relu(self.bn3(self.fc3(x2)))
        x4 = self.out(x3)
        return x4

# 3. 训练模型(会产出一个模型)
def train_model(train_data,input_dim,output_dim):
    # 生成数据加载器
    train_loader = torch.utils.data.DataLoader(train_data,batch_size=16,shuffle=True)
    # 创建模型
    model = PhonePriceModel(input_dim,output_dim)
    optimizer = torch.optim.Adam(model.parameters(),0.001,(0.9, 0.999))
    # 设置学习率下降策略
    scheduler = optim.lr_scheduler.ExponentialLR(optimizer, gamma=0.9)
    # 训练模型
    model.train() #开启训练模式
    for i in range(150):
        for x,y in train_loader:
            count = 0
            y_pre = model(x)
            # 计算损失0
            loss_fn = torch.nn.CrossEntropyLoss()
            y = y.long()
            loss = loss_fn(y_pre,y)
            # 自动微分
            loss.backward()
            # 更新参数
            optimizer.step ()
            # 学习率更新
            scheduler.step()
            # 梯度清空
            optimizer.zero_grad()
            # 损失累加
            count += loss.item()
        # 输出平均损失
        count  /= len(train_loader)
        print(f"第{i+1}轮,损失:{count:.5f}")
    # 保存模型
    torch.save(model.state_dict(),'111.pth')


# 4.模型预测
def predict(test_data,input_dim,output_dim):
    acc = 0
    # 将数据转化为数据加载器
    test_loader=torch.utils.data.DataLoader(test_data,batch_size=8,shuffle=False)
    model = PhonePriceModel(input_dim,output_dim)
    model.load_state_dict(torch.load('111.pth'))
    model.eval() # 开启测试模式
    for x,y in test_loader:
        y_pre = model(x)
        # 获取预测结果 --从数据中找最大的索引
        y_pre = torch.argmax(y_pre,dim=1)
        y = y.long()
        # print(y_pre)
        # print(y)
        # 计算预测对的个数
        acc += (y_pre==y).sum()
    # 计算正确率
    print(f"正确率:{acc/len(test_data)}")


if __name__ == '__main__':
    #1.准备数据
    test_data,train_data,input_dim,output_dim =creat_data()
    #2.构建模型
    model = PhonePriceModel(input_dim,output_dim)
    # 模型传参数
    summary(model,(input_dim,))
    # 3.训练模型
    train_model(train_data,input_dim,output_dim)
    # 4.模型预测
    predict(test_data,input_dim,output_dim)