DEEP LEARNING · 03
理解 PyTorch 自动微分机制,并完成线性模型的构建与训练。
- 自动微分
- 线性模型
自动微分与线性模型
步骤:1.定义W旧–标量张量
循环:
2.定义损失函数 – 模拟
3.对损失函数自动微分–得到梯度
4. 自动微分完成后梯度会自动更新 w.grad 梯度
5.利用梯度下降公式求出w新 w.data 当前权重
6.清空上次的梯度,否则会累加 w.grad.zero_
import torch
# 步骤
# 1.定义w旧 标量张量 requires_grad=True表示需要计算梯度
w = torch.tensor(10, requires_grad=True, dtype=torch.float32)
for i in range(20):
    # 2.定义损失函数 -- 模拟
    loss = 2*w**2
    # 每个损失函数只能微分一次,如果要重新计算就要重新定义
    # 3.对损失函数自动微分 --得到梯度
    loss.backward()

    # 自动微分完成后,梯度会自动更新
    # print("新梯度", w.grad)

    # 4.利用梯度下降公式求出w新 -w.data表示当前权重(假设学习率为0.1)
    w.data = w - 0.1 * w.grad
    # 清空上次的w.grad,否则会一直累加
    w.grad.zero_()
    print(f"第{i+1}次迭代后,w的值为:{w.data}")


# 自动微分后张量不能转numpy,需要detach·()
w.detach().numpy()
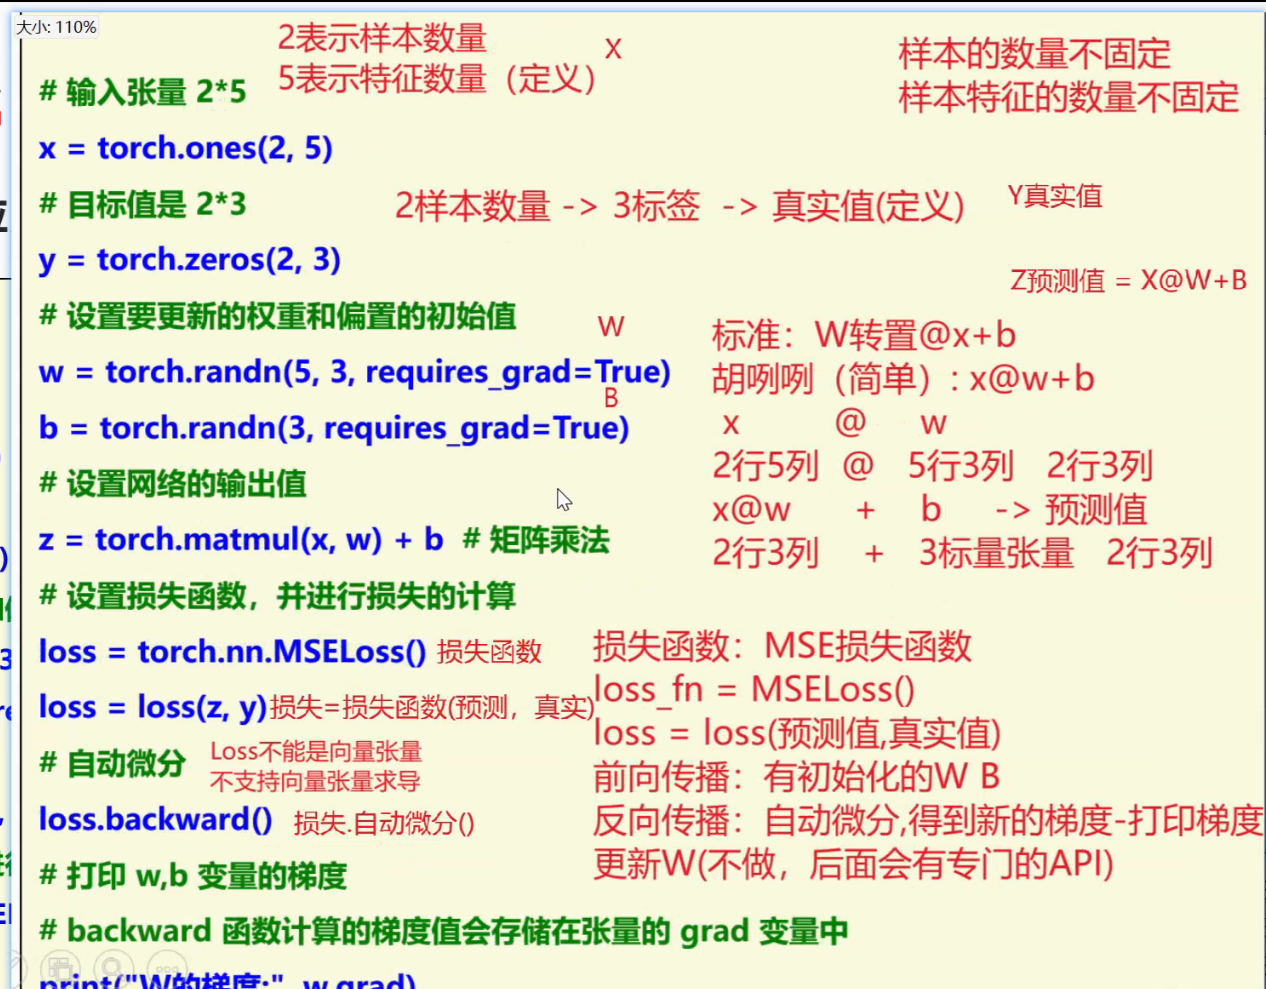
3.1自动微分模块的应用
# 思路
# 1.准备数据
# 1.1 准备输入的w x b y
# x 样本数据 2 特征数据 5
import torch
torch.manual_seed(3)
x = torch.ones(2,5)
# y 样本数据 2 标签数据 3
y = torch.randn(2,3)
# w (5,3)  因为要和x相乘,x的形状是(2,5)  所以w的形状是(5,2)
w = torch.randn(5,3,requires_grad=True,dtype=torch.float32)
# b 标量 3,
b = torch.randn(3,requires_grad=True,dtype=torch.float32)
# Z = W @ X + B  (2,3)

# 定义损失函数
loss_fn = torch.nn.MSELoss()
loss = loss_fn(x @ w + b, y)

# 对损失函数自动微分
loss.backward()

# 查看梯度
print('w微分',w.grad)
print('b微分',b.grad)
4.构建线性损失函数
构建线性损失函数的步骤:
1.准备数据 -> sklearn.datasets.make_regression
return x,y.reshape(-1,1),coef
2.训练模型
2.1 数据处理
数据 -> 张量(tensor) - > 数据集(TensorDataset) -> 数据加载器(DataLoader)
2.2 模型训练
2.2.1 模型准备
model = torch.nn.Linear(输入特征,输出特征)
2.2.2 优化器准备 – 更新w值
optimizer = torch.optim.SGD(模型参数,学习率)
2.2.3 模型预测
训练模型
y_pre = model(x_train)
损失函数实例化
loss_fn = torch.nn.MEALoss()
计算损失
loss = loss_fn(y_pre,y_train)
自动微分–损失函数求导得到梯度
loss.backword()
更新w、b值
optimizer.step()
梯度清零
optimizer.zero_grad()
最终结果
model.state_dict() – w值
coef 原始斜率
import torch
from sklearn.datasets import make_regression
from torch.utils.data import TensorDataset, DataLoader
import matplotlib.pyplot as plt
# 1,创建数据
def creat_data():
    x,y,coef=make_regression(
        n_samples=100,  # 样本数量
        n_features=1,   # 特征数量
        n_targets=1,    # 标签数量
        bias=3,         # 偏执 自定义
        noise=10,       # 噪声比例
        coef=True,       # 是否计算斜率
        random_state=3
    )

    print(type(x),type(y),type(coef))
    return x,y.reshape(-1,1),coef
    # y是[1,-1] 为了与x格式匹配方便后续处理 需要转成[-1,1]


def train(x,y,coef):
    # 1. 数据转张量
    # 返回的数据是numpy格式的数据,需要转成torch格式数据
    x = torch.tensor(x,dtype=torch.float32)
    y = torch.tensor(y,dtype=torch.float32)
    # 2.张量转成数据集
    dataset = TensorDataset(x,y)
    # 3.数据集转成数据加载器 #batch_size 批次训练数据量 shuffle 表示是否随机
    # 可以划分数据集,把原始数据集划分x_train,y_train
    dataloader = DataLoader(dataset,batch_size=16,shuffle=True)
    # 4.模型创建
    #4.1 准备模型
    model = torch.nn.Linear(in_features=1,out_features=1)
    #4.2 优化器创建 -- 更新w值 传入model的参数和学习率
    optimizer = torch.optim.SGD(model.parameters(),lr=0.01)
    # 记录数据
    loss_list = []
    loss_total,train_count=0,0
    #5. 训练
    #5.1 模型预测
    for i in range(100):
        for x_train,y_train in dataloader:
            y_pre = model(x_train)
            #5.2 损失函数
            loss_fn = torch.nn.MSELoss()
            loss = loss_fn(y_pre,y_train)
            # loss_list.append(loss.item())
            loss_total += loss.item()
            train_count += 1
            # 5. 3 自动微分
            loss.backward()
            # 5.4  更新数据
            optimizer.step()
            # 5.5  梯度清零
            optimizer.zero_grad()
        # print(f"第{train_count}次训练,平均损失:{loss_total/train_count}")
        loss_list.append(loss_total/train_count)
#    打印最终结果
    print(f"loss_list:{len(loss_list)}")
    print(model.state_dict())
    print(coef)

    # 绘制图像
    # 1.绘制损失函数曲线
    # plt.plot(range(len(loss_list)),loss_list)
    # plt.show()
    # 2.绘制样本点
    plt.scatter(x,y)
    # numpy数据不能和tensor数据进行计算,但是tensor可以和numpy进行计算,所以要把x写前面,coef写前面会报错
    # 不能用y画因为有噪声
    plt.plot(x,x*coef+3,'r')
    # tensor数据不能和numpy数据进行绘制,需要把tensor转为numpy,但是x自动微分过,所以tensor转为numpy需要使用detach()方法
    # 这里的model已经获得了最后计算的w、b值
    plt.plot(x,[i.detach().numpy() for i in model(x)],'g')
    plt.title("Linear Regression")
    plt.xlabel("x")
    plt.ylabel("y")
    plt.legend(["Data","Linear Regression","Predict"])
    plt.show()


if __name__ == '__main__':
    x,y,coef=creat_data()
    train(x,y,coef)