RETRIEVAL-AUGMENTED GENERATION · 02
认识向量表示、相似度计算、BGE-M3、稠密与稀疏检索、混合检索和重排。
- Embedding
- BGE-M3
- Hybrid Search
本文目录
Embedding 与检索基础
1.1 Embedding的概念
- Embedding(嵌入) 是将非结构化数据(文本、图片、音频)转换为固定长度的浮点数向量的技术。在文本领域,Embedding 模型接收一段文字,输出一串数字(通常是 512 到 4096 维的向量),这个向量在数学空间中代表了这段文字的“语义位置”。
1.2 为什么要使用embedding
- 计算机本质上只能做数值计算。要让计算机“理解”两段文字是否相似,必须先把文字变成它可以计算的数字。早期方法(如 TF-IDF、Bag-of-Words)只统计词频和共现关系,现代 Embedding 模型基于 Transformer 架构,通过大规模预训练学会了理解上下文中的语义。同一个词在不同上下文中会产生不同的向量表示。
1.3 向量相似度的计算
-
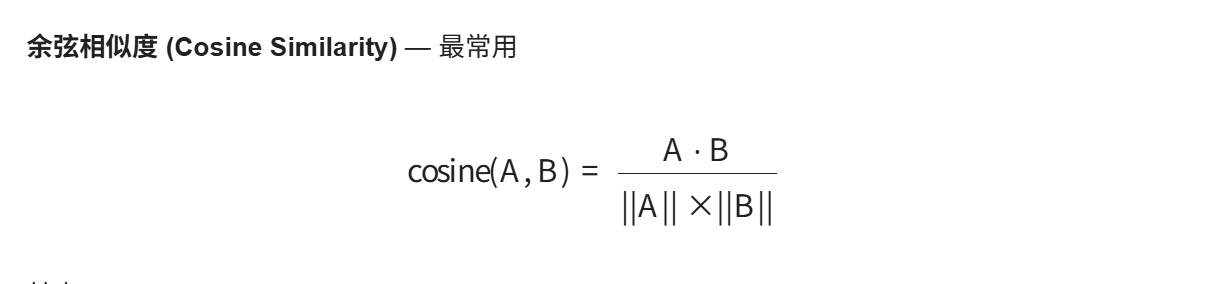
余弦相似度
-
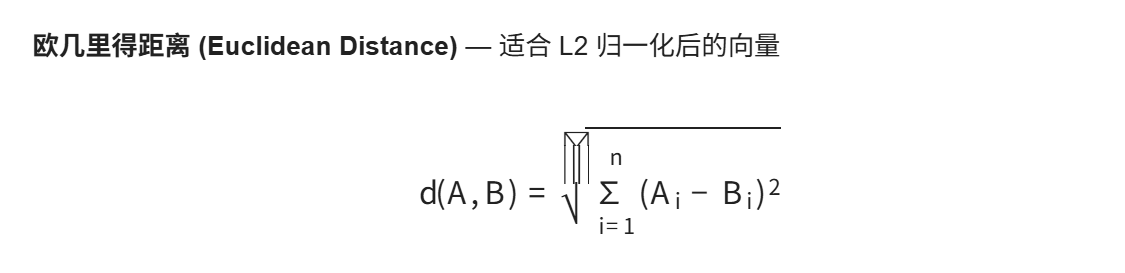
欧式距离
-
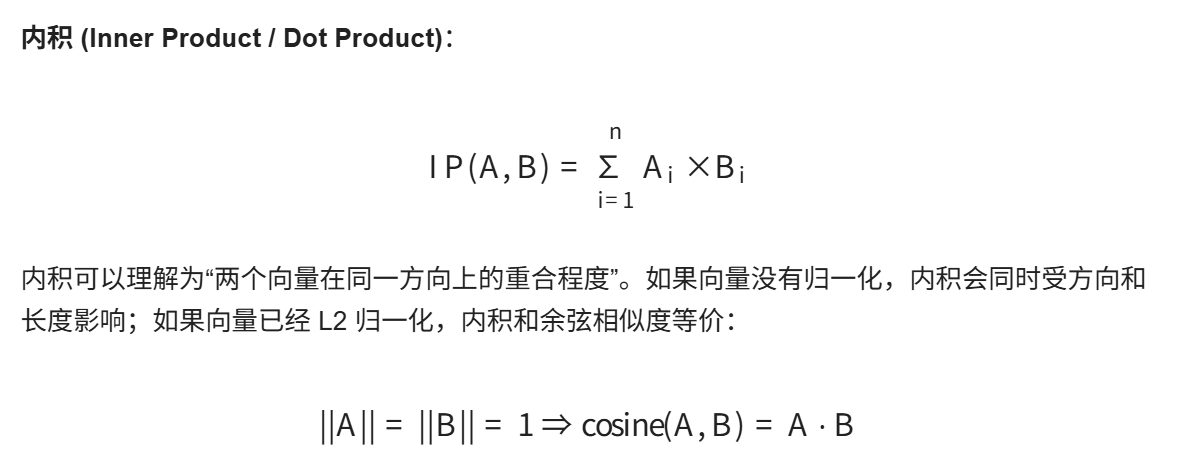
内积运算
1.4 BGE M3
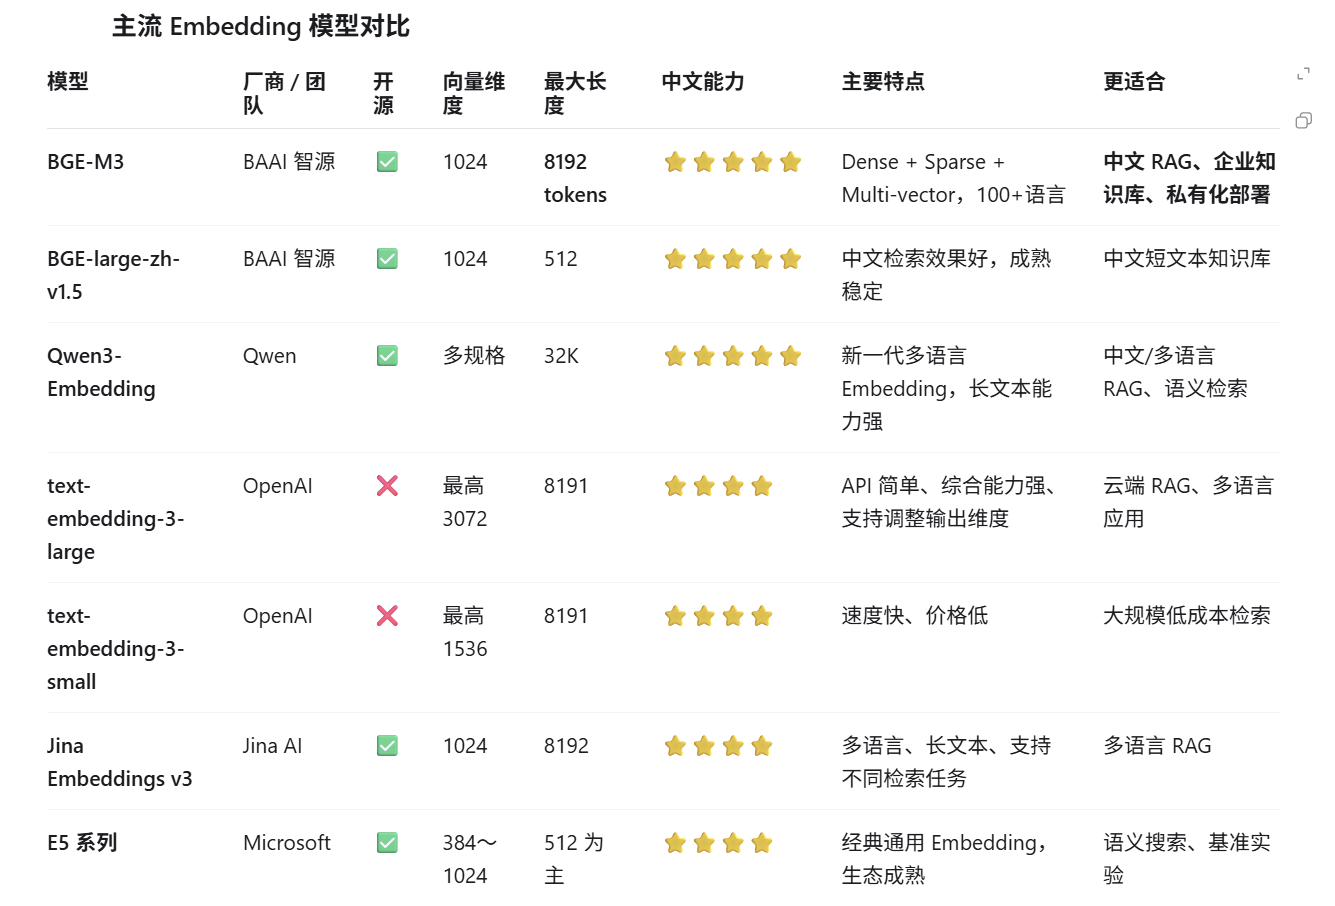
为什么选择bge m3?
- 我们当时对比过 BGE、OpenAI Embedding 以及其他开源 Embedding 模型,最后选择 BGE-M3 主要有几个原因。第一,我们的知识库以中文文档为主,同时存在一些中英文混合内容,BGE-M3 对中文和多语言的支持比较好;第二,它支持最长 8192 tokens,相比一些只能处理较短文本的 Embedding 模型,更适合企业 PDF、产品文档等长文本知识库;第三,BGE-M3 不仅支持 Dense Retrieval(稠密向量),还支持 Sparse Retrieval(稀疏向量) 和 Multi-vector Retrieval(多向量检索),所以我们后续可以结合关键词检索和语义检索做 Hybrid Search(混合检索),提高召回率;第四,我们的项目需要考虑数据隐私和私有化部署,BGE-M3 是开源模型,可以部署在自己的服务器上,不需要把企业知识库数据发送到外部 API。
- 所以综合考虑中文效果、长文本、混合检索、部署成本以及数据安全之后,我们最终选择了 BGE-M3。
1.5 BM25
- M25(Best Matching 25)是信息检索领域用于计算查询词与文档相关性的核心排序算法。它建立在经典的 TF-IDF 模型之上,但针对 TF-IDF 在真实复杂数据场景下的固有缺陷进行了深度优化:
- 引入词频饱和度
- 引入文档长度归一化
- 参数灵活性与鲁棒性
1.6 Dense 检索 (语义相似度)(稠密向量检索)
- 模型:bge m3
- 检索方式:向量库余弦相似度匹配
- 优点:能精准理解语义,同义词和改写都能识别
- 缺点:对专业术语、编号、代码等精确匹配较弱
1.7 Sparse 检索(关键词匹配)(稀疏向量检索)
- 模型:BM25
- 检索方式:关键词检索
- 优点:精确匹配专业术语、编号,对生僻词和专有名词效果极好 - 计算效率高,不需要 GPU
- 缺点:不理解语义和同义词
1.8 Hybrid Search(混合检索)
- 混合检索通过并行执行稠密向量检索(语义)与稀疏关键词检索(BM25),从海量数据中快速召回候选集。它通常采用 RRF(倒数排名融合)算法,基于文档在各路检索中的排名进行融合去重,选出 Top-N 送入下一环节,核心目标是保障高召回率。
1.9 Rerank(重排序)
- Rerank 采用 Cross-Encoder(交叉编码器)架构,将用户问题与召回的候选文档拼接为一对进行深度交叉比对与匹配度计算。它会对候选集重新打分并筛选出最精准的 Top-K 结果送给大模型,核心目标是在有限的上下文窗口内保障极高的准确率。